Das Wichtigste in Kürze
- DSGVO-konforme KI braucht vier Dinge: einen Auftragsverarbeitungsvertrag nach Art. 28, Verarbeitung in der EU oder in Deutschland, abgeschaltetes Training und eine Rechtsgrundlage für jede Übermittlung in die USA.
- Das EU-US Data Privacy Framework gilt im Oktober 2026 noch, ein Rechtsmittel ist aber anhängig und das FTC-Urteil des US Supreme Court hat es geschwächt. Halten Sie Standardvertragsklauseln als Rückfallebene bereit.
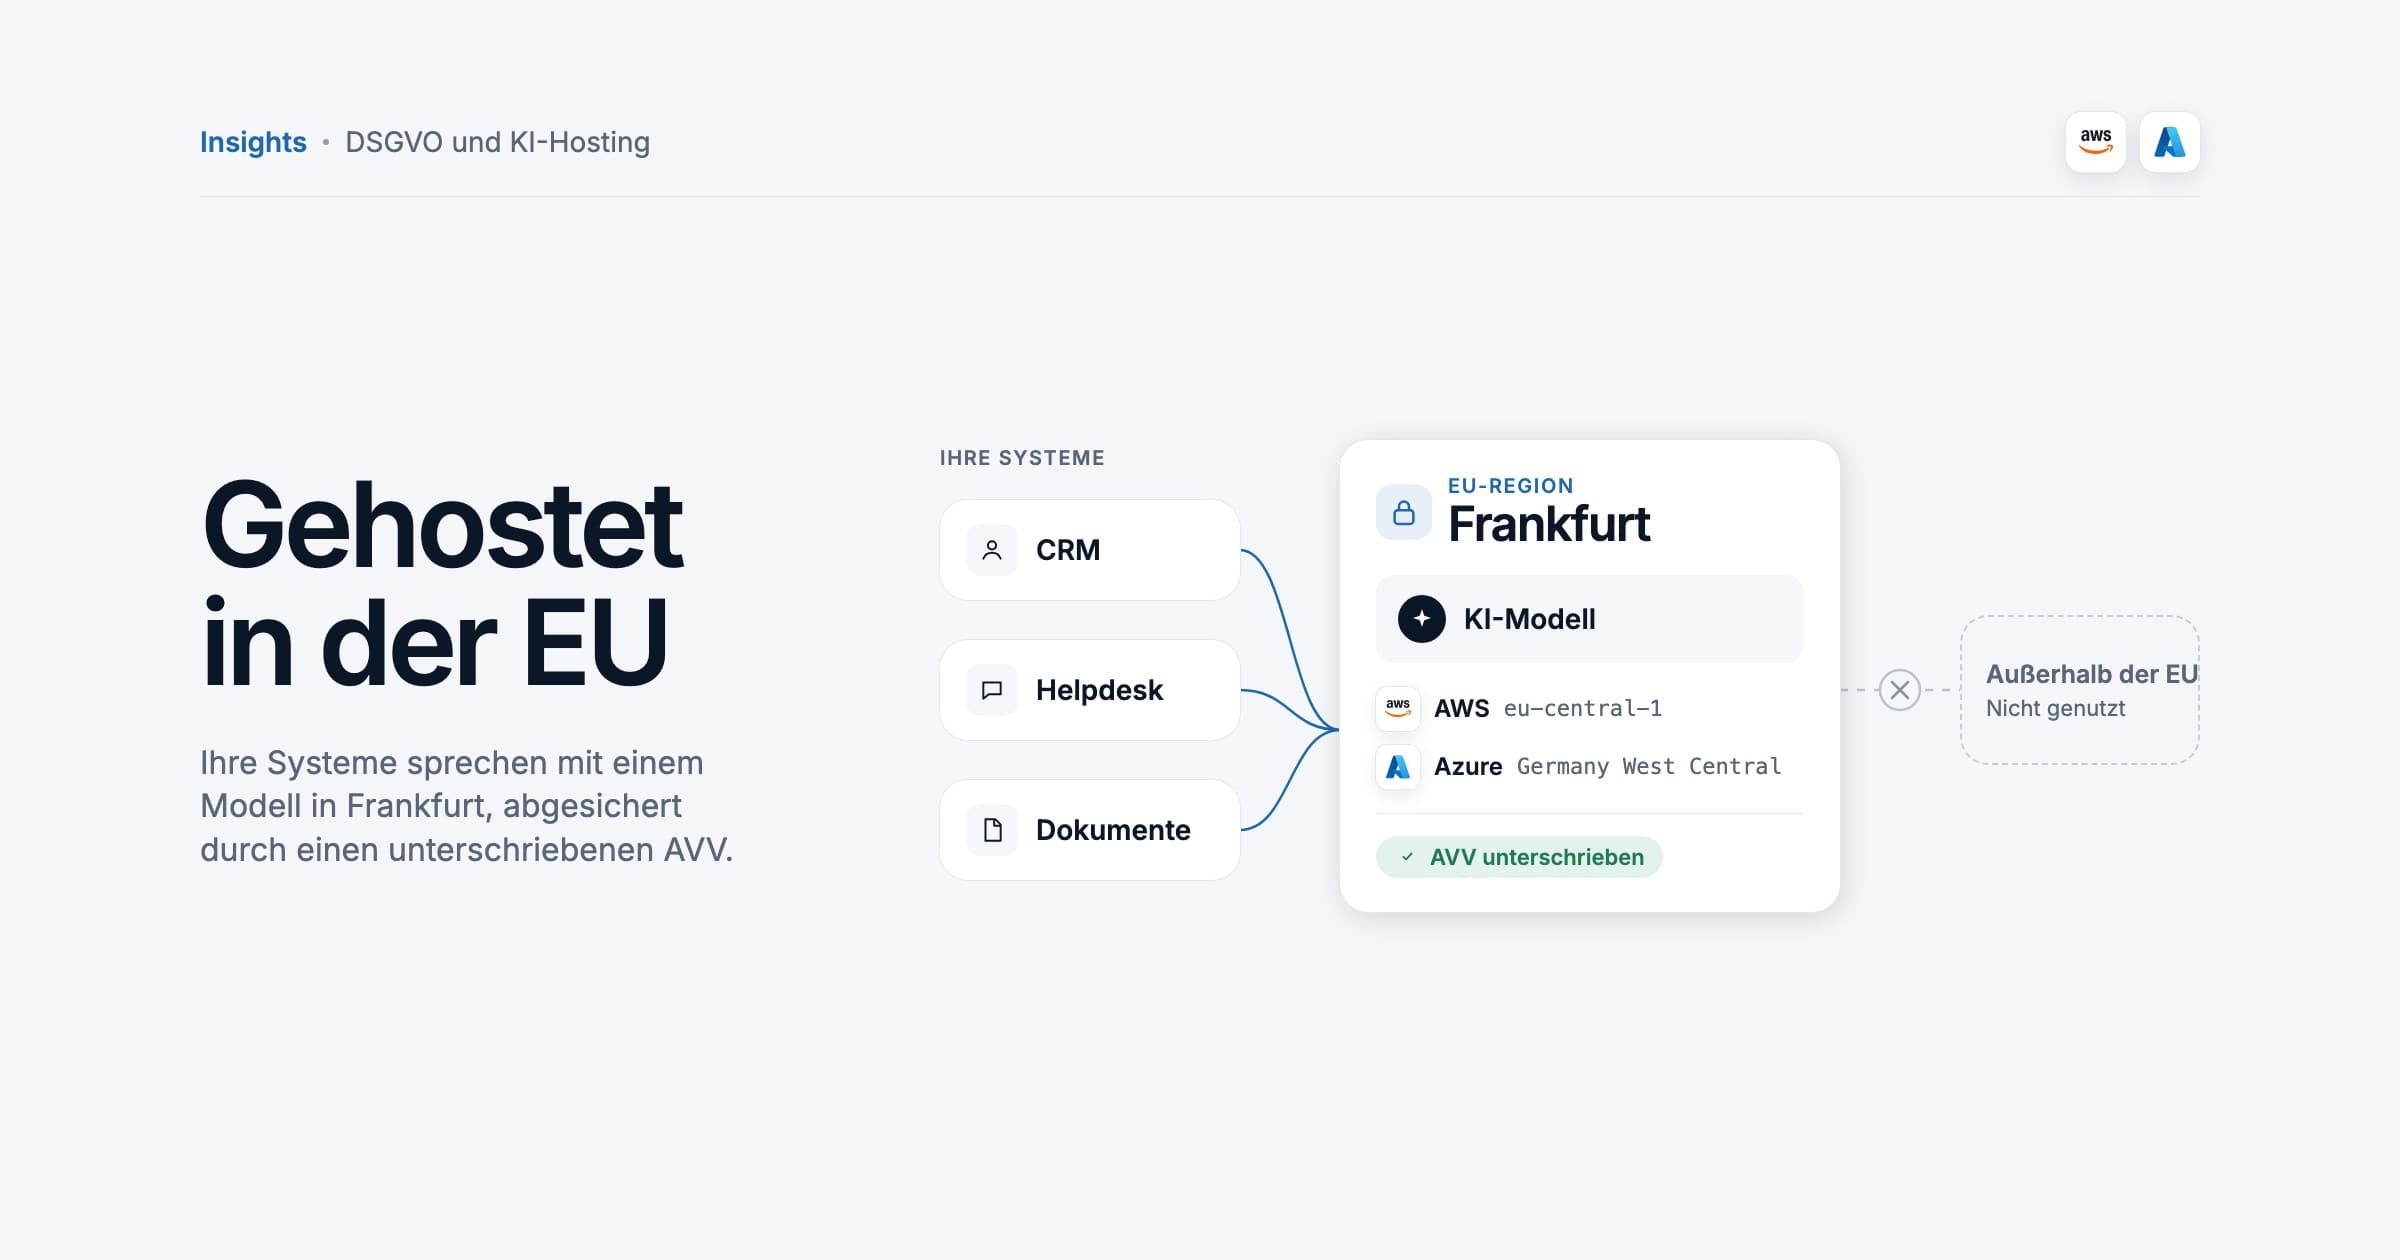
- Azure, AWS, Google und OpenAI bieten Verarbeitung in der EU; die eigene API von Anthropic nicht. Nutzen Sie Claude deshalb über Amazon Bedrock oder Google Vertex AI in der EU.
- Die deutsche DSK bevorzugt technisch geschlossene Systeme und erwartet für viele KI-Anwendungen eine DSFA, auch für Chatbots im Kundenkontakt.
- Am häufigsten übersehen wird die Aufbewahrung: Sicherheitsprotokolle der Anbieter, gespeicherte Antworten und Ihre eigenen Traces enthalten personenbezogene Daten.
Allgemeine Informationen, keine Rechts- oder Steuerberatung. Gesetze und Fristen ändern sich: Prüfen Sie die Quellen und fragen Sie Ihre Anwältin, Ihren Anwalt oder Ihre Steuerberatung, bevor Sie handeln.
Bei DSGVO-konformer KI geht es weniger um das Modell als um den Weg, den Ihre Daten nehmen. Fügt eine Mitarbeiterin eine Kunden-E-Mail in einen Chatbot ein oder ruft ein Agent ein Modell über eine API auf, gehen personenbezogene Daten an einen Anbieter, der als Ihr Auftragsverarbeiter handelt. Dort werden sie oft bis zu 30 Tage zur Missbrauchsüberwachung gespeichert und unter Umständen außerhalb der EU verarbeitet, sofern Sie nichts anderes wählen. Um konform zu bleiben, brauchen Sie vier Dinge: einen Auftragsverarbeitungsvertrag nach Art. 28 DSGVO, ein Deployment, das Daten in der EU oder in Deutschland verarbeitet, abgeschaltetes Training mit Ihren Daten und eine Rechtsgrundlage für jede Übermittlung in die USA.
Dieser Leitfaden gibt den Stand vom 11. Oktober 2026 wieder. Die Optionen der Anbieter ändern sich alle paar Monate, prüfen Sie jede Einstellung also in Ihrem eigenen Vertrag und Ihrer eigenen Konsole.
Wohin Ihre Daten gehen, wenn jemand ein KI-Modell nutzt
Ein einzelner Prompt macht selten nur einen Weg. Zeichnen Sie diese Stationen auf, bevor Sie darüber diskutieren, welches Modell das beste ist, denn jede ist ein Empfänger, ein Speicherort oder beides.
- Die Oberfläche. Ein Chat im Browser, ein Office-Add-in, ein CRM-Plugin. Verbraucher- und Business-Tarife haben unterschiedliche Bedingungen, selbst beim selben Anbieter.
- Ihre Orchestrierungsschicht. Der Server oder das Low-Code-Tool, das den Prompt zusammensetzt und den Zustand speichert. Ist das ein in den USA gehostetes SaaS, haben die Daten die EU verlassen, bevor irgendein Modell sie sieht.
- Der Modell-Endpunkt. Wo die Inferenz physisch läuft. „Globale“ Deployments können eine Anfrage in jede Region mit freier Kapazität leiten.
- Sicherheitsspeicher des Anbieters. Die meisten Anbieter speichern Prompts und Ausgaben zur Missbrauchsüberwachung, typischerweise bis zu 30 Tage, sofern Sie nicht für Zero Data Retention freigeschaltet sind.
- Zustandsbehaftete Funktionen. Threads, gespeicherte Antworten, Dateien, Vektorspeicher und Caches bleiben bestehen, bis Sie sie löschen.
- Werkzeuge, die der Agent aufruft. Websuche, Grounding, E-Mail, Ticketsystem. Jeder Tool-Aufruf kann personenbezogene Daten an einen weiteren Empfänger senden.
- Ihre eigenen Protokolle. Prompt-Logs, Tracing-Werkzeuge und Evaluierungsdatensätze enthalten oft die vollständigste Kopie von allem.
Verantwortlicher, Auftragsverarbeiter und der AVV
Entscheidet Ihr Unternehmen, warum und wie personenbezogene Daten in einen KI-Dienst gehen, sind Sie Verantwortlicher. Ein Anbieter, der das Modell nur nach Ihren Weisungen betreibt, etwa Microsoft bei Azure OpenAI oder AWS bei Bedrock, ist in der Regel Ihr Auftragsverarbeiter. Die DSK, das gemeinsame Gremium der deutschen Datenschutzaufsichtsbehörden, sieht das ebenso: Wer eine externe KI-Anwendung in der Cloud für eigene Zwecke nutzt, begründet meist eine Auftragsverarbeitung nach Art. 28, die einen Vertrag erfordert. Betreiben Sie ein Open-Weight-Modell auf eigenen Servern für eigene Zwecke, sind Sie in der Regel alleiniger Verantwortlicher, und es gibt keinen Modellanbieter, mit dem Sie einen Vertrag schließen müssten.
Erfolgt eine Verarbeitung im Auftrag eines Verantwortlichen, so arbeitet dieser nur mit Auftragsverarbeitern, die hinreichend Garantien dafür bieten, dass geeignete technische und organisatorische Maßnahmen so durchgeführt werden, dass die Verarbeitung im Einklang mit den Anforderungen dieser Verordnung erfolgt und den Schutz der Rechte der betroffenen Person gewährleistet.
In der Praxis ist der AVV der Standardnachtrag des Anbieters zu seinen Enterprise- oder API-Bedingungen. Verbraucherkonten kommen meist ohne. Die DSK geht davon aus, dass die unkontrollierte Nutzung solcher Tools durch Beschäftigte in vielen Organisationen längst Realität ist: Schließen Sie diese Lücke zuerst.
- Verarbeitung nur auf Ihre dokumentierte Weisung, einschließlich keiner Nutzung Ihrer Daten zum Training der Modelle des Anbieters (Art. 28 Abs. 3 lit. a).
- Eine aktuelle Liste der Unterauftragsverarbeiter mit ihren Standorten und ein Widerspruchsrecht gegen neue (Art. 28 Abs. 2 und 4).
- Wo Verarbeitung und Speicherung stattfinden, getrennt ausgewiesen, einschließlich Supportzugriffen von außerhalb der EU.
- Aufbewahrungsfristen für Prompts, Ausgaben, Dateien und Protokolle sowie Löschung bei Vertragsende (Art. 28 Abs. 3 lit. g).
- Der Übermittlungsmechanismus für alles, was außerhalb des EWR verarbeitet wird: Angemessenheitsbeschluss, Standardvertragsklauseln oder beides.
- Sicherheitsnachweise, etwa eine Zertifizierung nach ISO/IEC 27001 oder ein BSI-C5-Testat.
Drittlandübermittlung: Data Privacy Framework, SCC und CLOUD Act
Kapitel V der DSGVO (Art. 44 bis 49) erlaubt Übermittlungen außerhalb des EWR nur auf Grundlage eines Angemessenheitsbeschlusses, geeigneter Garantien wie Standardvertragsklauseln (SCC) oder einer eng gefassten Ausnahme. Für die USA ist der Angemessenheitsbeschluss das EU-US Data Privacy Framework vom 10. Juli 2023. Es erfasst nur US-Unternehmen, die sich selbst zertifiziert haben, prüfen Sie also jeden Anbieter auf der offiziellen DPF-Liste.
Stand 11. Oktober 2026: Das Framework gilt. Das Gericht der EU hat die Nichtigkeitsklage von Philippe Latombe am 3. September 2025 abgewiesen (Rechtssache T-553/23); sein Rechtsmittel (Rechtssache C-703/25 P) ist beim Gerichtshof anhängig. Am 29. Juni 2026 entschied der US Supreme Court in Trump v. Slaughter, dass der Präsident FTC-Kommissare nach Belieben abberufen darf. Die Unabhängigkeit der FTC ist eine tragende Säule des Angemessenheitsbeschlusses; noyb hat die Kommission deshalb aufgefordert, ihn zurückzunehmen, und eine weitere Klage angekündigt. Bis ein Gericht oder die Kommission handelt, bleiben Übermittlungen an zertifizierte Unternehmen rechtmäßig.
SCC (Durchführungsbeschluss (EU) 2021/914 der Kommission) erfordern ein Transfer Impact Assessment: Untergräbt US-Recht, insbesondere die Überwachung nach FISA Section 702, die Klauseln, und welche zusätzlichen Maßnahmen schließen die Lücke? Ein Modell muss Klartext lesen, um zu antworten. Verschlüsselung hilft daher nur bei der Übertragung und im Ruhezustand; den größten Teil der Arbeit leistet die Minimierung dessen, was Sie senden.
EU-Datenresidenz beendet die Diskussion nicht. Der US CLOUD Act erlaubt US-Behörden, von US-Anbietern die Herausgabe von Daten in deren Besitz, Gewahrsam oder Kontrolle zu verlangen, gleich wo sie gespeichert sind. Die Verarbeitung in Frankfurt durch die EU-Gesellschaft eines US-Anbieters ist für sich keine Übermittlung. Nach Auffassung des EDSA ist das Risiko widersprüchlicher nationaler Gesetze oder unverhältnismäßiger staatlicher Zugriffe bei der Wahl eines Auftragsverarbeiters dennoch abzuwägen. Für die meisten Geschäftsdaten ist das ein dokumentierbares Risiko; bei Berufsgeheimnissen wählen viele Organisationen einen Anbieter in europäischer Hand oder hosten selbst.
Optionen zur EU-Datenresidenz bei den großen Anbietern
Jede große Plattform bietet inzwischen Verarbeitung in der EU an, die Voreinstellungen unterscheiden sich aber. Die Tabelle gibt die Dokumentation der Anbieter mit Prüfstand Oktober 2026 wieder.
| Plattform | So bleibt die Verarbeitung in der EU oder in Deutschland | Worauf Sie achten sollten |
|---|---|---|
| Azure OpenAI in Microsoft Foundry | Ein Standard-Deployment (regional) verarbeitet Daten in der Geografie Ihrer Ressource, etwa Deutschland. Ein DataZone-Deployment in einer EU-Ressource hält die Verarbeitung innerhalb der EU-Mitgliedstaaten. | Globale Deployments, auch Global Batch, können überall verarbeiten. Prompts, die zur menschlichen Missbrauchsprüfung ausgewählt werden, bleiben in Ihrer Geografie; das Abschalten erfordert eine Freigabe. |
| Amazon Bedrock | Modelle in Frankfurt (eu-central-1) aufrufen, wo verfügbar, oder ein EU-Inferenzprofil über mehrere Regionen nutzen, das die Verarbeitung in EU-Regionen hält. Die AWS European Sovereign Cloud in Brandenburg, seit Januar 2026 in Betrieb, bietet Bedrock in einer getrennten EU-Partition. | Globale Profile leiten weltweit. Einige neuere Modelle brauchen einen Aufbewahrungsmodus, in dem AWS Prompts bis zu 30 Tage zur menschlichen Prüfung speichern darf. |
| Google Vertex AI | Einen regionalen Endpunkt wie europe-west3 (Frankfurt) oder den EU-Multiregion-Endpunkt nutzen, der nur EU-Mitgliedstaaten umfasst. | Der globale Endpunkt gibt keine Residenzgarantie. Ein In-Memory-Cache mit 24 Stunden Lebensdauer ist standardmäßig aktiv und lässt sich abschalten; Grounding mit der Google-Suche speichert Protokolle bis zu drei Tage. |
| OpenAI API und ChatGPT Enterprise | Datenresidenz in Europa (EWR und Schweiz) mit Verarbeitung in der Region für berechtigte API-Kunden, je neuem Projekt einzustellen. Speicherung in Europa für berechtigte ChatGPT-Enterprise- und Edu-Workspaces. | Erfordert eine Freigabe durch OpenAI plus Zero Data Retention oder angepasste Missbrauchsüberwachung; bestehende Projekte lassen sich nicht umstellen. Standardmäßig werden Missbrauchsprotokolle der API bis zu 30 Tage aufbewahrt. |
| Anthropic Claude API | Keine EU-Option auf der eigenen API: Die Inferenzgeografie ist „global“ oder „us“, die Workspace-Speicherung erfolgt nur in den USA. Für Verarbeitung in der EU nutzen Sie Claude über EU-Profile in Bedrock oder EU-Endpunkte in Vertex AI. | Die regionale Verfügbarkeit in Bedrock und Vertex AI unterscheidet sich je Claude-Version. Prüfen Sie jedes Modell, bevor Sie sich festlegen. |
| Open-Weight-Modelle in deutschen Rechenzentren | Modelle wie Llama, Mistral, Qwen oder gpt-oss auf eigenen GPUs betreiben oder über eine verwaltete deutsche API wie STACKIT, IONOS oder T-Systems nutzen. | Sicherheit, Patches, Kapazität und Qualität liegen bei Ihnen. Prüfen Sie die Modelllizenz und ob ein verwalteter Anbieter Anfragen speichert. |
Zwei Unterscheidungen zählen mehr als die Marke. Speicherort und Verarbeitungsort sind getrennte Zusagen: Mehrere „globale“ Optionen speichern Daten in der EU, lassen die Inferenz aber anderswo laufen. Und die EU-Region eines US-Anbieters löst die Übermittlungsfrage, nicht die Frage des CLOUD Act.
Selbst hosten ist realistisch geworden. Mit Retrieval-Augmented Generation (RAG) reicht ein mittelgroßes Open-Weight-Modell, das aus Ihren eigenen Dokumenten antwortet, für interne Suche und Entwürfe oft aus. Die RAG-Orientierungshilfe der DSK vom Oktober 2025 hält fest, dass so kleinere, lokal betriebene Modelle möglich werden, ohne personenbezogene Daten an Hyperscaler weiterzugeben, RAG aber ein rechtswidrig trainiertes Modell nicht heilt.
Training mit Ihren Daten, Protokollierung und Aufbewahrung
Die Business- und API-Bedingungen der großen Anbieter schließen das Training mit Ihren Prompts ohne Erlaubnis aus. Verbrauchertarife sind anders. OpenAI und Anthropic lassen Verbraucher entscheiden, ob Chats künftige Modelle trainieren, und Anthropic speichert Verbraucherchats bis zu fünf Jahre, wenn ein Nutzer das Training erlaubt. Deshalb will die DSK Beschäftigte auf Firmenkonten sehen, mit standardmäßig abgeschaltetem Training und Chatverlauf.
- Missbrauchsüberwachung der Anbieter. Standardmäßig bis zu 30 Tage bei OpenAI und bei einigen Bedrock-Modellen; Azure speichert zur menschlichen Prüfung ausgewählte Prompts in Ihrer Geografie, sofern Sie nicht für eine angepasste Missbrauchsüberwachung freigeschaltet sind.
- Zero Data Retention. Bei den großen Anbietern für berechtigte Kunden verfügbar, meist aber nicht für zustandsbehaftete Funktionen wie Dateien, Vektorspeicher oder Codeausführung.
- Zustandsbehaftete Funktionen. Gespeicherte Antworten, Threads und hochgeladene Dateien bleiben, bis Sie sie löschen. Schalten Sie die Speicherung ab, wo Sie keinen Verlauf brauchen.
- Ihre eigenen Protokolle. Legen Sie eine Frist fest (etwa 30 Tage für vollständige Prompt-Logs), pseudonymisieren Sie Nutzerkennungen, beschränken Sie den Zugriff und löschen Sie automatisch. Art. 5 Abs. 1 lit. e verlangt das, und ein Protokoll, das Sie nicht aufbewahren, kann nicht abfließen.
Prompt-Logs, die Beschäftigte identifizieren, können Verhalten oder Leistung überwachen. Das löst das Mitbestimmungsrecht des Betriebsrats nach § 87 Abs. 1 Nr. 6 BetrVG aus. Vereinbaren Sie die Protokollierung deshalb vor der Einführung in einer Betriebsvereinbarung.
Was die DSK erwartet und wann Sie eine DSFA brauchen
Drei Papiere der DSK sind für KI-Anwender maßgeblich: die Orientierungshilfe zu KI und Datenschutz vom Mai 2024, die Orientierungshilfe zu technischen und organisatorischen Maßnahmen vom Juni 2025 und die Orientierungshilfe zu RAG vom Oktober 2025. Sie sind nicht verbindlich, zeigen aber, wie die Behörden, die Sie prüfen würden, die DSGVO lesen.
Technisch geschlossene Systeme sind daher aus datenschutzrechtlicher Sicht vorzugswürdig.
Gemeint sind Systeme, bei denen Sie Ein- und Ausgaben kontrollieren und der Anbieter nicht damit trainiert. Dieselbe Orientierungshilfe verlangt, dass Sie prüfen, ob das Modell rechtmäßig trainiert wurde, das Training mit Ihren Eingaben nach Möglichkeit ausschließen, schriftlich intern regeln, welche Tools wofür genutzt werden dürfen, und Beschäftigten dienstliche Geräte und Konten statt privater zur Verfügung stellen.
Eine Datenschutz-Folgenabschätzung (DSFA) nach Art. 35 ist Pflicht, wenn eine Verarbeitung voraussichtlich ein hohes Risiko zur Folge hat, und die DSK geht davon aus, dass das bei vielen KI-Einsätzen der Fall ist. Ihre Muss-Liste für den nicht öffentlichen Bereich nennt unter Nr. 11 den Einsatz von KI zur Verarbeitung personenbezogener Daten, um die Interaktion mit Betroffenen zu steuern oder persönliche Aspekte zu bewerten, mit KI im Kundensupport als Beispiel. Typische Auslöser:
- Ein Chatbot oder Voice-Agent im Kundenkontakt, der personenbezogene Daten verarbeitet.
- KI, die Menschen bewertet, reiht oder profiliert: Bewerber, Beschäftigte, Kredit- oder Betrugsrisiko.
- Besondere Kategorien personenbezogener Daten nach Art. 9, etwa Gesundheitsdaten, oder Daten über Kinder.
- Systematische Überwachung von Beschäftigten, einschließlich der Auswertung ihrer Prompts.
Bleibt ein hohes Restrisiko, verlangt Art. 36, dass Sie vor dem Start die Aufsichtsbehörde konsultieren. Fragen Sie Anbieter früh nach der Dokumentation, die Sie für die Risikobewertung brauchen.
Welches Setup zu welchen Daten passt
| Daten | Beispiele | Setup, das meist passt | Mindestmaßnahmen |
|---|---|---|---|
| Keine personenbezogenen Daten | Öffentliche Webinhalte, Marketingentwürfe, Code ohne Geheimnisse | Jeder Business-Tarif oder jede API mit abgeschaltetem Training; globales Routing ist vertretbar | Nutzungsrichtlinie, Firmenkonten |
| Gewöhnliche personenbezogene Daten | Kunden-E-Mails, CRM-Notizen, Supporttickets, Besprechungsnotizen | Deployment mit Verarbeitung in der EU: Azure regional oder EU DataZone, Bedrock in Frankfurt oder mit EU-Profil, EU-Endpunkt in Vertex AI, OpenAI mit Datenresidenz Europa | AVV, Verarbeitung in der EU, Training aus, Aufbewahrung von höchstens 30 Tagen, Übermittlungsgrundlage für jeden US-Zugriff |
| Sensibel oder hohes Risiko | Gesundheitsdaten, Personalbeurteilungen, Bewerberauswahl, Daten über Kinder | Regionales Deployment in Deutschland mit Zero Retention oder angepasster Missbrauchsüberwachung oder ein selbst gehostetes Open-Weight-Modell | DSFA, strenger Zugriff, menschliche Prüfung von Entscheidungen (Art. 22), kurze Aufbewahrung der Protokolle |
| Berufsgeheimnisse und Kronjuwelen | Patientenakten, Mandantenakten von Anwälten und Steuerberatern, unveröffentlichte Finanzzahlen, Forschung und Entwicklung | Open-Weight-Modell auf eigener Infrastruktur oder bei einem deutschen Anbieter in europäischer Hand | Verpflichtung zur Verschwiegenheit nach § 203 StGB, wo einschlägig, rechtliche Prüfung, kein Zugriff aus Drittländern |
Ein durchgerechnetes Beispiel
Ein fiktives Logistikunternehmen mit 400 Beschäftigten in Nordrhein-Westfalen möchte einen Agenten, der rund 1.500 Kunden-E-Mails pro Woche liest, Antworten entwirft und das CRM aktualisiert. Die E-Mails enthalten Namen, Adressen und Beschwerden über beschädigte Ware: gewöhnliche personenbezogene Daten, aber im Kundenkontakt und in großem Umfang, also ist eine DSFA fällig.
Ein sinnvolles Setup: Orchestrierung im eigenen Azure-Tenant des Unternehmens in Deutschland, ein Modell-Deployment in der EU DataZone, gespeicherte Antworten abgeschaltet, Prompt-Logs 30 Tage mit pseudonymisierten Kennungen, CRM-Zugriff beschränkt auf Notizentwürfe und eine Person, die jede Antwort freigibt. Der AVV von Microsoft deckt die Verarbeitung ab, Framework und SCC decken verbleibende US-Zugriffe ab, und der Betriebsrat stimmt der Protokollierung zu.
Checkliste: bevor Sie einschalten
Einführung DSGVO-konformer KI
- Jedes genutzte KI-Tool erfassen, auch private Konten, und festlegen, welche wofür erlaubt sind.
- Den Datenfluss je Anwendungsfall zeichnen: Oberfläche, Orchestrierung, Modell-Endpunkt, Werkzeuge, Speicher und Protokolle.
- Den AVV des Anbieters unterzeichnen, die Liste der Unterauftragsverarbeiter ablegen und die Verarbeitung in Ihr Verzeichnis nach Art. 30 aufnehmen.
- Ein Deployment wählen, das Daten in der EU oder in Deutschland verarbeitet, und globales Routing per Richtlinie sperren, wo möglich.
- Schriftlich bestätigen lassen, dass Ein- und Ausgaben nicht zum Training genutzt werden, und das Training auf jedem Konto abschalten.
- Die Übermittlungsgrundlage für jeden US-Zugriff dokumentieren: DPF-Zertifizierung, SCC und ein Transfer Impact Assessment.
- Aufbewahrungsfristen festlegen für Missbrauchsprotokolle der Anbieter, gespeicherte Antworten, Dateien, Vektorspeicher, Caches und Ihre eigenen Protokolle.
- Ein DSFA-Screening durchführen und für Anwendungen im Kundenkontakt, im Personalwesen oder mit sensiblen Daten eine vollständige DSFA.
- Datenschutzhinweise aktualisieren (Art. 13 und 14), KI-Nutzung und Protokollierung mit dem Betriebsrat vereinbaren und Beschäftigte schulen, was in einen Prompt darf.
- Das Setup alle sechs Monate überprüfen: Bedingungen der Anbieter, Modellregionen und der Rechtsstatus des Frameworks ändern sich oft.
Wie wir Sie unterstützen
Bespoke IT Consultants baut KI-Agenten und Automatisierungen für Unternehmen in der DACH-Region, mit Hosting in der EU oder in Deutschland, gewählt je Anwendungsfall. Ein KI-Audit erfasst Ihre Tools, Datenflüsse und Lücken, oder sprechen Sie uns an, um einen konkreten Anwendungsfall durchzugehen. Für die rechtliche Freigabe ziehen Sie Ihren Datenschutzbeauftragten hinzu und bei hohem Risiko eine Anwältin oder einen Anwalt.
Eine Frage zu Ihrem eigenen Setup?
Fragen Sie unseren KI-Coworker. Er antwortet in Sekunden, und eine Person aus unserem Team meldet sich danach.

Bespoke One Coworker. KI-Assistent. Antworten in Sekunden, Schätzung in drei Minuten.