En bref
- Une IA conforme au RGPD exige quatre choses : un contrat de traitement des données au sens de l’article 28, un traitement dans l’UE ou en Allemagne, l’entraînement désactivé et une base légale pour tout transfert vers les États-Unis.
- L’EU-US Data Privacy Framework est toujours en vigueur en octobre 2026, mais un pourvoi est pendant et l’arrêt de la Cour suprême des États-Unis sur la FTC l’a fragilisé : conservez les clauses contractuelles types comme solution de repli.
- Azure, AWS, Google et OpenAI proposent un traitement dans l’UE, mais pas l’API directe d’Anthropic : utilisez Claude via Amazon Bedrock ou Google Vertex AI dans l’UE.
- La DSK allemande privilégie les systèmes techniquement fermés et attend une AIPD pour de nombreux usages de l’IA, y compris les chatbots en contact avec la clientèle.
- La conservation est le risque le plus négligé : journaux de sécurité des fournisseurs, réponses stockées et vos propres traces contiennent tous des données personnelles.
Informations générales, et non un conseil juridique ou fiscal. Les lois et les échéances évoluent : vérifiez les sources et consultez votre avocat ou votre conseiller fiscal avant d’agir.
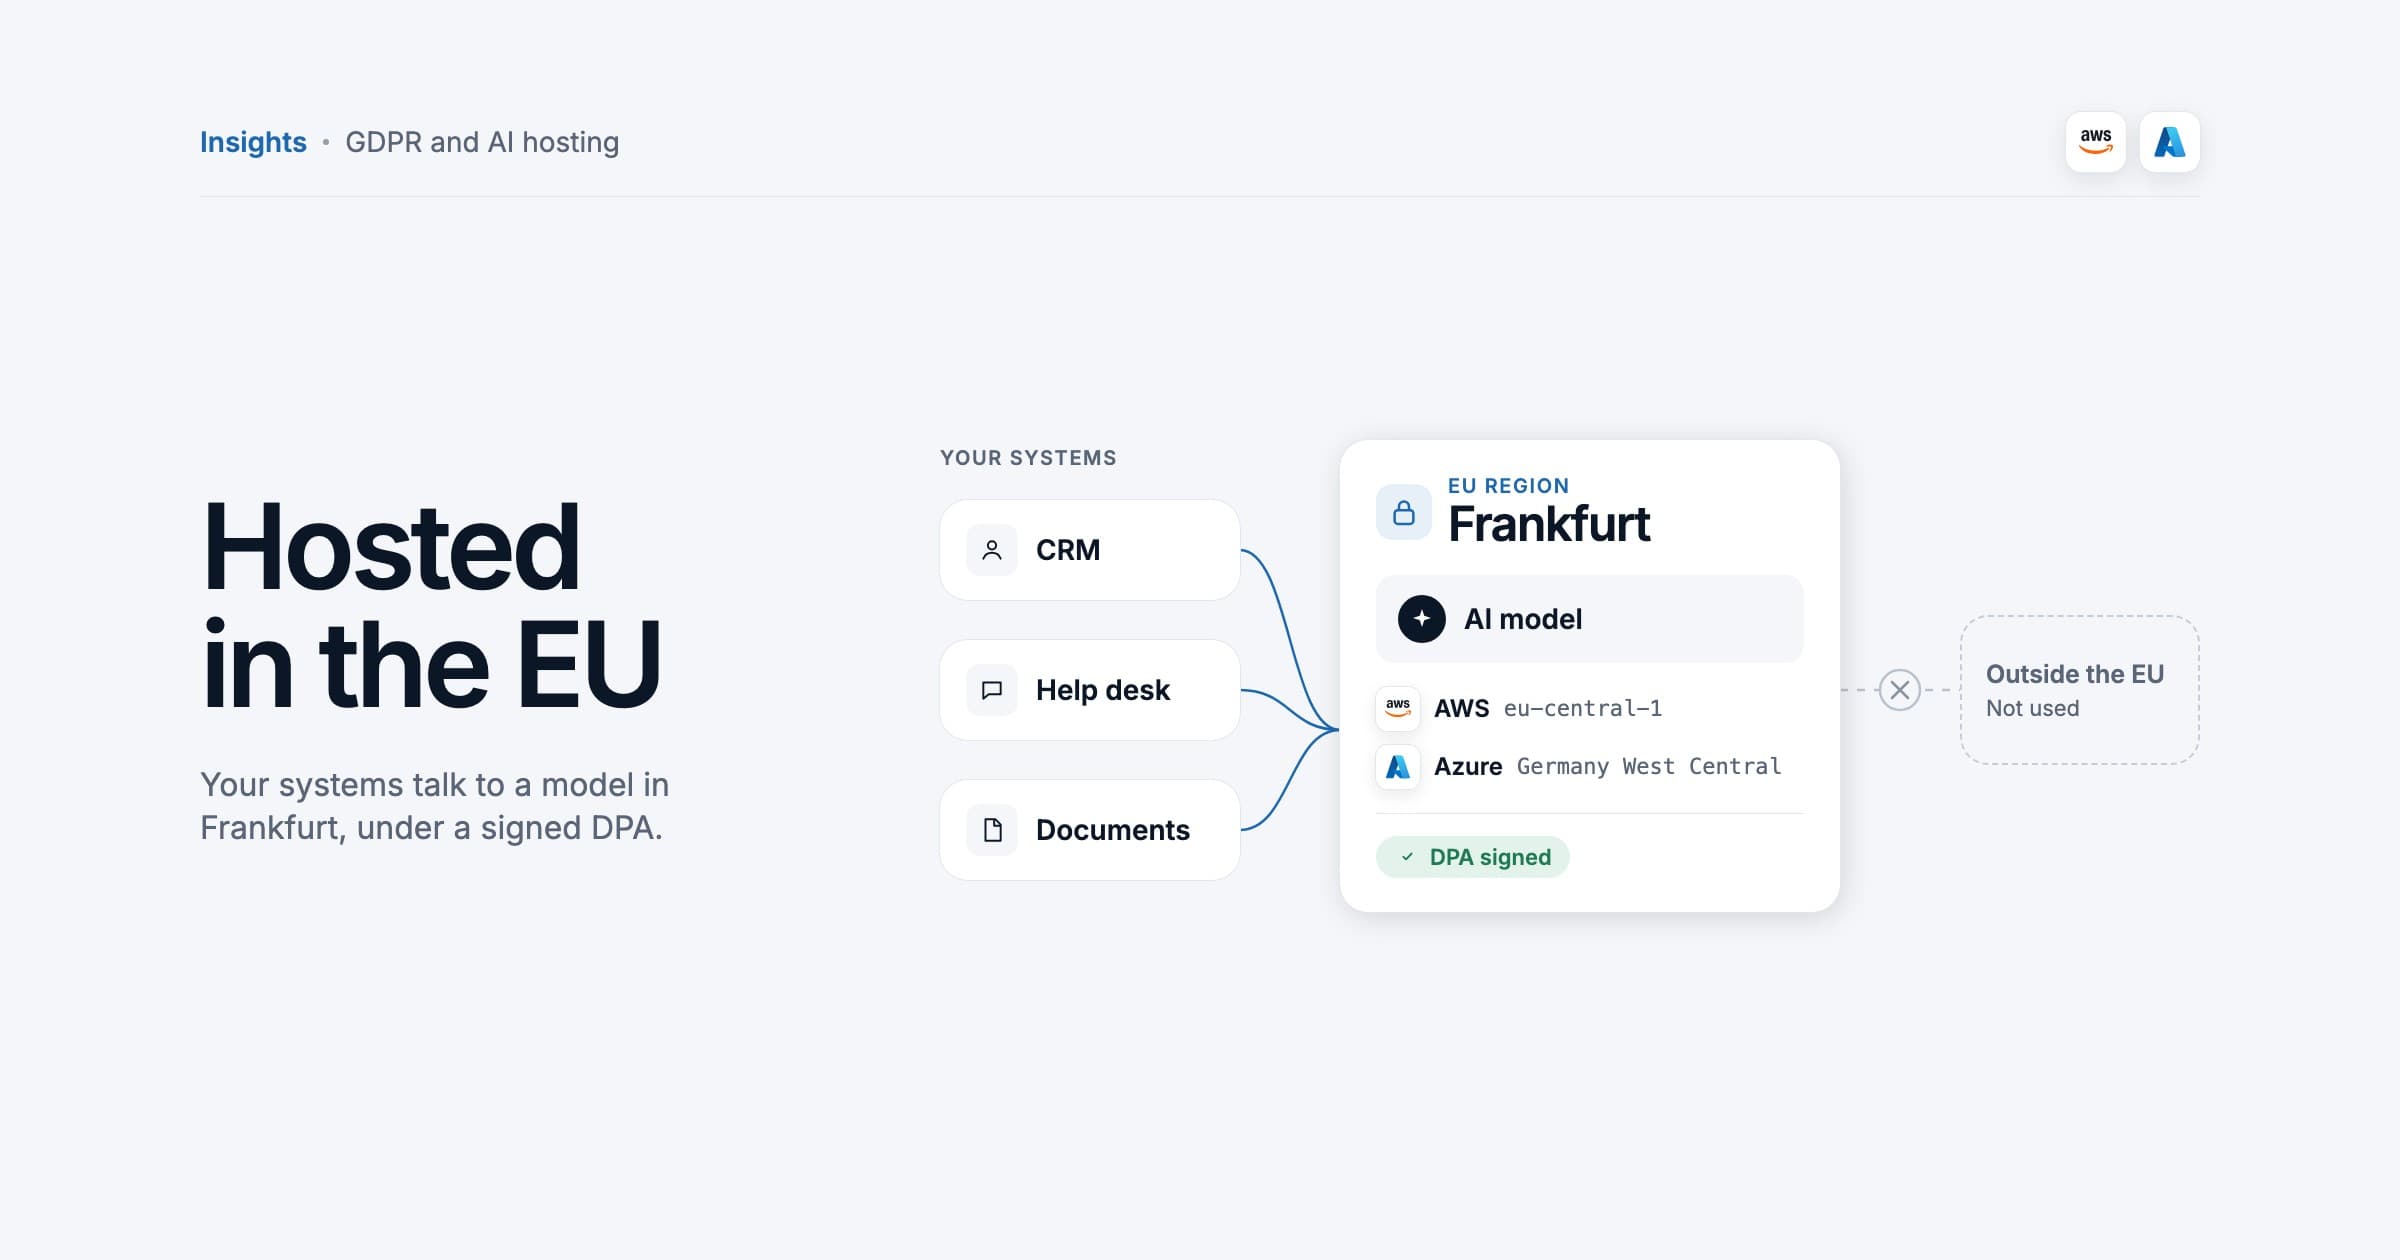
Une IA conforme au RGPD dépend moins du modèle que du chemin emprunté par vos données. Lorsqu’un salarié colle l’e-mail d’un client dans un chatbot, ou qu’un agent appelle un modèle via une API, des données personnelles partent chez un fournisseur qui agit comme votre sous-traitant, sont souvent conservées jusqu’à 30 jours pour la surveillance des abus et peuvent être traitées hors de l’UE si vous n’en décidez pas autrement. Pour rester en conformité, il vous faut quatre choses : un contrat de traitement des données (DPA) au sens de l’article 28 du RGPD, un déploiement qui traite les données dans l’UE ou en Allemagne, l’entraînement sur vos données désactivé et une base légale pour tout transfert vers les États-Unis.
Ce guide reflète la situation au 11 octobre 2026. Les options des fournisseurs changent tous les quelques mois : vérifiez chaque paramètre dans votre propre contrat et votre propre console.
Où vont vos données quand quelqu’un utilise un modèle d’IA
Une requête fait rarement un seul trajet. Cartographiez ces étapes avant de débattre du meilleur modèle, car chacune est un destinataire, un lieu de stockage, ou les deux.
- L’interface. Un chat dans le navigateur, un complément Office, un plugin CRM. Les offres grand public et professionnelles ont des conditions différentes, même chez le même fournisseur.
- Votre couche d’orchestration. Le serveur ou l’outil low-code qui construit la requête et conserve l’état. S’il s’agit d’un SaaS hébergé aux États-Unis, les données ont quitté l’UE avant même qu’un modèle ne les voie.
- Le point de terminaison du modèle. L’endroit où l’inférence s’exécute physiquement. Les déploiements « globaux » peuvent acheminer une requête vers n’importe quelle région disposant de capacité libre.
- Le stockage de sécurité du fournisseur. La plupart des fournisseurs conservent requêtes et réponses pour la surveillance des abus, en général jusqu’à 30 jours, sauf si vous êtes autorisé à la conservation zéro des données (zero data retention).
- Les fonctions avec état. Fils de discussion, réponses stockées, fichiers, bases vectorielles et caches persistent jusqu’à ce que vous les supprimiez.
- Les outils appelés par l’agent. Recherche web, ancrage (grounding), e-mail, ticketing. Chaque appel d’outil peut envoyer des données personnelles à un autre destinataire.
- Vos propres journaux. Journaux de requêtes, outils de traçage et jeux de données d’évaluation contiennent souvent la copie la plus complète de toutes.
Responsable du traitement, sous-traitant et contrat de traitement des données
Lorsque votre entreprise décide pourquoi et comment des données personnelles entrent dans un service d’IA, vous êtes le responsable du traitement. Un fournisseur qui exécute le modèle uniquement sur vos instructions, comme Microsoft pour Azure OpenAI ou AWS pour Bedrock, est normalement votre sous-traitant. La DSK, l’instance commune des autorités allemandes de protection des données, partage cette analyse : utiliser une application d’IA cloud externe pour vos propres finalités crée en général une relation de sous-traitance au sens de l’article 28, qui exige un contrat. Si vous exécutez un modèle open-weight sur vos propres serveurs pour vos propres finalités, vous êtes en général seul responsable du traitement et il n’existe aucun fournisseur de modèle avec qui contracter.
Lorsqu’un traitement doit être effectué pour le compte d’un responsable du traitement, celui-ci fait uniquement appel à des sous-traitants qui présentent des garanties suffisantes quant à la mise en œuvre de mesures techniques et organisationnelles appropriées de manière à ce que le traitement réponde aux exigences du présent règlement et garantisse la protection des droits de la personne concernée.
En pratique, le DPA est l’avenant standard du fournisseur à ses conditions entreprise ou API. Les comptes grand public n’en prévoient généralement pas, et la DSK considère que l’usage incontrôlé de ces outils par le personnel est déjà une réalité dans de nombreuses organisations : comblez d’abord cette lacune.
- Un traitement uniquement sur vos instructions documentées, y compris aucune utilisation de vos données pour entraîner les modèles du fournisseur (article 28, paragraphe 3, point a).
- Une liste à jour des sous-traitants ultérieurs avec leur localisation, et un droit d’opposition aux nouveaux (article 28, paragraphes 2 et 4).
- Le lieu du traitement et celui du stockage, indiqués séparément, y compris l’accès du support depuis l’extérieur de l’UE.
- Les durées de conservation des requêtes, réponses, fichiers et journaux, et la suppression à la fin du contrat (article 28, paragraphe 3, point g).
- Le mécanisme de transfert pour tout ce qui est traité hors de l’EEE : décision d’adéquation, clauses contractuelles types, ou les deux.
- Des preuves de sécurité, par exemple une certification ISO/IEC 27001 ou une attestation BSI C5.
Transferts internationaux : Data Privacy Framework, clauses contractuelles types et CLOUD Act
Le chapitre V du RGPD (articles 44 à 49) n’autorise les transferts hors de l’EEE que sur la base d’une décision d’adéquation, de garanties appropriées telles que les clauses contractuelles types (CCT), ou d’une dérogation étroite. Pour les États-Unis, la décision d’adéquation est l’EU-US Data Privacy Framework du 10 juillet 2023. Il ne couvre que les entreprises américaines qui se sont auto-certifiées : vérifiez donc chaque fournisseur sur la liste officielle du DPF.
Situation au 11 octobre 2026 : le cadre est en vigueur. Le Tribunal de l’Union européenne a rejeté le recours en annulation de Philippe Latombe le 3 septembre 2025 (affaire T-553/23) ; son pourvoi (affaire C-703/25 P) est pendant devant la Cour de justice. Le 29 juin 2026, la Cour suprême des États-Unis a jugé dans l’affaire Trump v. Slaughter que le Président peut révoquer à sa discrétion les commissaires de la FTC. L’indépendance de la FTC est l’un des piliers de la décision d’adéquation : noyb a donc demandé à la Commission de la retirer et annoncé un nouveau recours en justice. Tant qu’un tribunal ou la Commission n’a pas agi, les transferts vers des entreprises certifiées restent licites.
Les CCT (décision d’exécution (UE) 2021/914 de la Commission) exigent une analyse d’impact des transferts : le droit américain, notamment la surveillance au titre de la section 702 du FISA, compromet-il les clauses, et quelles mesures supplémentaires comblent l’écart ? Un modèle doit lire du texte en clair pour répondre, si bien que le chiffrement n’aide qu’en transit et au repos ; c’est la minimisation de ce que vous envoyez qui fait l’essentiel du travail.
La résidence des données dans l’UE ne clôt pas le débat. Le CLOUD Act américain permet aux autorités américaines d’exiger des fournisseurs américains qu’ils divulguent les données en leur possession, sous leur garde ou sous leur contrôle, où qu’elles soient stockées. Un traitement à Francfort par l’entité européenne d’un fournisseur américain n’est pas en soi un transfert, mais le CEPD (comité européen de la protection des données) indique que le risque de « législations nationales contradictoires ou d’accès disproportionné des autorités publiques » doit tout de même être pesé lors du choix d’un sous-traitant. Pour la plupart des données d’entreprise, c’est un risque documentable ; pour les secrets professionnels, de nombreuses organisations choisissent un fournisseur détenu par des capitaux européens ou l’auto-hébergement.
Options de résidence des données dans l’UE chez les grands fournisseurs
Toutes les grandes plateformes proposent désormais un traitement dans l’UE, mais leurs réglages par défaut diffèrent. Le tableau reflète la documentation de chaque fournisseur telle que vérifiée en octobre 2026.
| Plateforme | Comment garder le traitement dans l’UE ou en Allemagne | Points de vigilance |
|---|---|---|
| Azure OpenAI dans Microsoft Foundry | Un déploiement Standard (régional) traite les données dans la zone géographique de votre ressource, par exemple l’Allemagne. Un déploiement DataZone dans une ressource UE maintient le traitement dans les États membres de l’UE. | Les déploiements Global, y compris Global Batch, peuvent traiter les données n’importe où. Les requêtes sélectionnées pour un examen humain des abus restent dans votre zone géographique ; désactiver cet examen nécessite une autorisation. |
| Amazon Bedrock | Appelez les modèles à Francfort (eu-central-1) lorsqu’ils y sont proposés, ou utilisez un profil d’inférence interrégional UE, qui maintient le traitement dans les régions de l’UE. L’AWS European Sovereign Cloud dans le Brandebourg, en service depuis janvier 2026, propose Bedrock dans une partition européenne distincte. | Les profils globaux acheminent les requêtes dans le monde entier. Certains modèles récents exigent un mode de conservation qui permet à AWS de garder les requêtes jusqu’à 30 jours pour un examen humain. |
| Google Vertex AI | Utilisez un point de terminaison régional tel que europe-west3 (Francfort) ou le point de terminaison multirégional UE, qui ne couvre que les États membres de l’UE. | Le point de terminaison global n’offre aucune garantie de résidence. Un cache en mémoire d’une durée de vie de 24 heures est activé par défaut et peut être désactivé ; l’ancrage avec Google Search conserve des journaux jusqu’à trois jours. |
| API OpenAI et ChatGPT Enterprise | Résidence des données en Europe (EEE et Suisse) avec traitement dans la région pour les clients API éligibles, à définir pour chaque nouveau projet. Stockage au repos en Europe pour les espaces de travail ChatGPT Enterprise et Edu éligibles. | Nécessite l’accord d’OpenAI ainsi que la conservation zéro des données ou une surveillance des abus modifiée ; les projets existants ne peuvent pas être basculés. Par défaut, les journaux d’abus de l’API sont conservés jusqu’à 30 jours. |
| API Claude d’Anthropic | Aucune option UE sur l’API directe d’Anthropic : la géographie d’inférence est « global » ou « us », et le stockage de l’espace de travail se fait uniquement aux États-Unis. Pour un traitement dans l’UE, utilisez Claude via les profils UE de Bedrock ou les points de terminaison UE de Vertex AI. | La disponibilité régionale sur Bedrock et Vertex AI varie selon les versions de Claude : vérifiez chaque modèle avant de vous engager. |
| Modèles open-weight dans des centres de données allemands | Exécutez des modèles tels que Llama, Mistral, Qwen ou gpt-oss sur vos propres GPU ou via une API managée allemande comme STACKIT, IONOS ou T-Systems. | Sécurité, correctifs, capacité et qualité sont à votre charge. Vérifiez la licence du modèle et si un fournisseur managé conserve les requêtes. |
Deux distinctions comptent plus que la marque. Le lieu de stockage et le lieu de traitement sont deux promesses distinctes : plusieurs options « globales » stockent les données dans l’UE mais exécutent l’inférence ailleurs. Et la région européenne d’un fournisseur américain règle la question du transfert, pas celle du CLOUD Act.
L’auto-hébergement est devenu réaliste. Avec la génération augmentée par récupération (RAG), un modèle open-weight de taille moyenne qui répond à partir de vos propres documents suffit souvent pour la recherche interne et la rédaction. Le guide de la DSK sur le RAG d’octobre 2025 note que cette approche permet d’utiliser des modèles plus petits, exécutés localement, sans transmettre de données personnelles aux hyperscalers, mais que le RAG ne corrige pas un modèle entraîné de manière illicite.
Entraînement sur vos données, journalisation et conservation
Les conditions professionnelles et API des grands fournisseurs excluent l’entraînement sur vos requêtes sans autorisation. Les offres grand public diffèrent. OpenAI et Anthropic laissent les utilisateurs grand public décider si leurs conversations servent à entraîner les futurs modèles, et Anthropic conserve les conversations grand public jusqu’à cinq ans lorsqu’un utilisateur autorise l’entraînement. C’est pourquoi la DSK veut que le personnel utilise des comptes d’entreprise, avec l’entraînement et l’historique des conversations désactivés par défaut.
- Surveillance des abus par le fournisseur. Jusqu’à 30 jours par défaut chez OpenAI et pour certains modèles Bedrock ; Azure stocke dans votre zone géographique les requêtes sélectionnées pour un examen humain, sauf si vous êtes autorisé à une surveillance des abus modifiée.
- Conservation zéro des données. Proposée par les grands fournisseurs aux clients éligibles, mais en général pas pour les fonctions avec état comme les fichiers, les bases vectorielles ou l’exécution de code.
- Fonctions avec état. Les réponses stockées, les fils de discussion et les fichiers téléversés restent jusqu’à ce que vous les supprimiez. Désactivez le stockage là où vous n’avez pas besoin d’historique.
- Vos propres journaux. Fixez une durée (par exemple 30 jours pour les journaux complets des requêtes), pseudonymisez les identifiants des utilisateurs, restreignez l’accès et supprimez automatiquement. L’article 5, paragraphe 1, point e) l’exige, et un journal que vous ne conservez pas ne peut pas fuiter.
Les journaux de requêtes qui identifient des salariés peuvent permettre de surveiller leur comportement ou leur performance, ce qui déclenche le droit de codécision du comité d’entreprise (Betriebsrat) prévu au § 87, al. 1, n° 6 BetrVG : convenez donc de la conception de la journalisation dans un accord d’entreprise avant le déploiement.
Ce qu’attend la DSK allemande, et quand une AIPD est nécessaire
Trois documents de la DSK comptent pour les utilisateurs d’IA : le guide de mai 2024 sur l’IA et la protection des données, le guide de juin 2025 sur les mesures techniques et organisationnelles, et le guide d’octobre 2025 sur le RAG. Ils ne sont pas contraignants, mais ils montrent comment les autorités qui vous contrôleraient lisent le RGPD.
Technisch geschlossene Systeme sind daher aus datenschutzrechtlicher Sicht vorzugswürdig.
En français : les systèmes techniquement fermés, dans lesquels vous contrôlez les entrées et les sorties et où le fournisseur ne s’en sert pas pour l’entraînement, sont préférables du point de vue de la protection des données. Le même guide vous demande de vérifier que le modèle a été entraîné de manière licite, d’exclure l’entraînement sur vos entrées lorsque c’est possible, de fixer par écrit des règles internes sur les outils autorisés et leurs usages, et de fournir au personnel des appareils et des comptes d’entreprise plutôt que privés.
Une analyse d’impact relative à la protection des données (AIPD) au sens de l’article 35 est obligatoire lorsque le traitement est susceptible d’engendrer un risque élevé, et la DSK s’attend à ce que ce soit le cas pour de nombreux déploiements d’IA. Sa liste obligatoire pour le secteur privé cite, au point 11, l’utilisation de l’IA pour traiter des données personnelles afin de piloter l’interaction avec les personnes concernées ou d’évaluer des aspects personnels, avec le support client par IA comme exemple. Déclencheurs typiques :
- Un chatbot ou un agent vocal en contact avec la clientèle qui traite des données personnelles.
- Une IA qui note, classe ou profile des personnes : candidats, salariés, risque de crédit ou de fraude.
- Des catégories particulières de données au sens de l’article 9, comme les données de santé, ou des données concernant des enfants.
- La surveillance systématique des salariés, y compris l’analyse de leurs requêtes.
Si un risque résiduel élevé subsiste, l’article 36 vous impose de consulter l’autorité de contrôle avant la mise en production. Demandez tôt aux fournisseurs la documentation dont vous avez besoin pour évaluer le risque.
Quelle configuration pour quelles données
| Données | Exemples | Configuration généralement adaptée | Contrôles minimaux |
|---|---|---|---|
| Aucune donnée personnelle | Contenus web publics, brouillons marketing, code sans secrets | Toute offre professionnelle ou API avec l’entraînement désactivé ; le routage global est acceptable | Politique d’utilisation, comptes d’entreprise |
| Données personnelles ordinaires | E-mails clients, notes CRM, tickets de support, comptes rendus de réunion | Déploiement avec traitement dans l’UE : Azure régional ou EU DataZone, Bedrock à Francfort ou profil UE, point de terminaison UE de Vertex AI, résidence Europe d’OpenAI | DPA, traitement dans l’UE, entraînement désactivé, conservation de 30 jours maximum, base de transfert pour tout accès depuis les États-Unis |
| Sensibles ou à haut risque | Données de santé, évaluations RH, présélection de candidats, données concernant des enfants | Déploiement régional en Allemagne avec conservation zéro ou surveillance des abus modifiée, ou modèle open-weight auto-hébergé | AIPD, accès strict, contrôle humain des décisions (article 22), conservation courte des journaux |
| Secrets professionnels et actifs stratégiques | Dossiers patients, dossiers clients d’avocats et de conseillers fiscaux, données financières non publiées, R&D | Modèle open-weight sur votre propre infrastructure ou chez un fournisseur allemand détenu par des capitaux européens | Engagements de confidentialité au titre du § 203 StGB lorsqu’il s’applique, revue juridique, aucun accès depuis un pays tiers |
Un exemple concret
Une entreprise de logistique fictive de 400 salariés en Rhénanie-du-Nord-Westphalie veut un agent qui lit environ 1 500 e-mails clients par semaine, rédige des projets de réponse et met à jour le CRM. Les e-mails contiennent des noms, des adresses et des réclamations pour marchandises endommagées : des données personnelles ordinaires, mais en contact avec la clientèle et à grande échelle, donc une AIPD s’impose.
Une configuration raisonnable : orchestration dans le tenant Azure de l’entreprise en Allemagne, déploiement du modèle en EU DataZone, réponses stockées désactivées, journaux de requêtes conservés 30 jours avec identifiants pseudonymisés, accès au CRM limité aux brouillons de notes, et une personne qui valide chaque réponse. Le DPA de Microsoft couvre le traitement, le cadre et les CCT couvrent l’accès résiduel depuis les États-Unis, et le comité d’entreprise approuve la conception de la journalisation.
Checklist : avant la mise en service
Déploiement d’une IA conforme au RGPD
- Inventoriez chaque outil d’IA utilisé, y compris les comptes privés, et décidez lesquels sont autorisés et pour quoi.
- Dessinez le flux de données de chaque cas d’usage : interface, orchestration, point de terminaison du modèle, outils, stockages et journaux.
- Signez le DPA du fournisseur, archivez la liste des sous-traitants ultérieurs et ajoutez le traitement à votre registre de l’article 30.
- Choisissez un déploiement qui traite les données dans l’UE ou en Allemagne et bloquez le routage global par une politique là où c’est possible.
- Faites confirmer par écrit que les entrées et les sorties ne servent pas à l’entraînement, et désactivez l’entraînement sur chaque compte.
- Documentez la base de transfert pour tout accès depuis les États-Unis : certification DPF, CCT et analyse d’impact des transferts.
- Fixez la conservation des journaux d’abus du fournisseur, des réponses stockées, des fichiers, des bases vectorielles, des caches et de vos propres journaux.
- Réalisez un pré-examen AIPD, et une AIPD complète pour les cas d’usage en contact avec la clientèle, RH ou sensibles.
- Mettez à jour les mentions d’information (articles 13 et 14), convenez de l’usage de l’IA et de la journalisation avec le comité d’entreprise, et formez le personnel à ce qui peut figurer dans une requête.
- Réexaminez la configuration tous les six mois : les conditions des fournisseurs, les régions des modèles et le statut juridique du cadre changent souvent.
Comment nous pouvons vous aider
Bespoke IT Consultants conçoit des agents IA et des automatisations pour les entreprises de la région DACH, avec un hébergement dans l’UE ou en Allemagne choisi selon le cas d’usage. Un audit IA cartographie vos outils, vos flux de données et vos lacunes ; vous pouvez aussi nous contacter pour discuter d’un cas d’usage précis. Pour la validation juridique, impliquez votre délégué à la protection des données et, pour les cas à haut risque, un avocat.
Une question sur votre propre situation ?
Posez-la à notre collègue IA. Il répond en quelques secondes et une personne de notre équipe donne suite.

Bespoke One Coworker. Assistant IA. Réponses en quelques secondes, estimation en trois minutes.